Chatterbox — семейство открытых моделей Resemble AI для синтеза речи и воспроизведения голоса по аудиообразцу. С их помощью можно подготовить озвучку ролика, варианты рекламной реплики или локализацию на другом языке. Для русского нужен Multilingual; англоязычные Turbo и Nano решают другие задачи. Бесплатно доступны сами модели, а при самостоятельном запуске вычисления и настройку ты обеспечиваешь сам.
Что умеет Chatterbox
На вход модель получает текст, язык и при необходимости образец голоса. На выходе создаёт аудиодорожку, которую можно сохранить и перенести в видеоредактор. Обучать отдельную модель под каждый голос для такого сценария не требуется: Chatterbox использует короткую референсную запись непосредственно при генерации.
Для маркетингового продакшена это полезно, когда нужно озвучить несколько версий одного объявления или сохранить похожий голос в разных языковых версиях ролика. Текст, длительность и произношение каждой реплики всё равно придётся проверить. Chatterbox не переводит рекламный сценарий автоматически и не собирает готовый видеокреатив.
Под названием Chatterbox легко встретить сторонние сайты с платным доступом. Официальный разработчик — Resemble AI, основной проект находится в репозитории resemble-ai/chatterbox. Условия сторонней оболочки не определяют цену и ограничения открытой модели.
Какую версию выбрать
В семействе несколько моделей. Проверяй полное название перед запуском: уменьшенная англоязычная модель не заменяет многоязычную в русской озвучке.
| Модель | Языки и размер | Для какой задачи рассматривать |
| Multilingual V3 | Многоязычная, включая русский; 500 млн параметров | Русская озвучка, локализация и перенос голоса между языками |
| Turbo | Английский; 350 млн | Англоязычные реплики и голосовые приложения с меньшими вычислительными затратами |
| Nano | Английский; 110 млн | Запуск на ограниченном оборудовании, в том числе CPU |
| Original Chatterbox | Английский; 500 млн | Работа с исходной моделью и её настройками выразительности |
У Turbo и Nano есть специальные теги для звуков вроде смеха. Не переноси их автоматически в русский текст для Multilingual: поддержка таких управляющих вставок зависит от модели. Число параметров также не обещает определённую скорость на твоём компьютере.
Для Multilingual есть существенная настройка версии. В актуальном коде t3_model=»v3″ явно выбирает V3. Вызов без этого параметра по умолчанию загружает V2. Поэтому старый пример с ChatterboxMultilingualTTS.from_pretrained(device=…) может работать, но запускать другую версию, чем ты ожидаешь.
Как попробовать Chatterbox онлайн
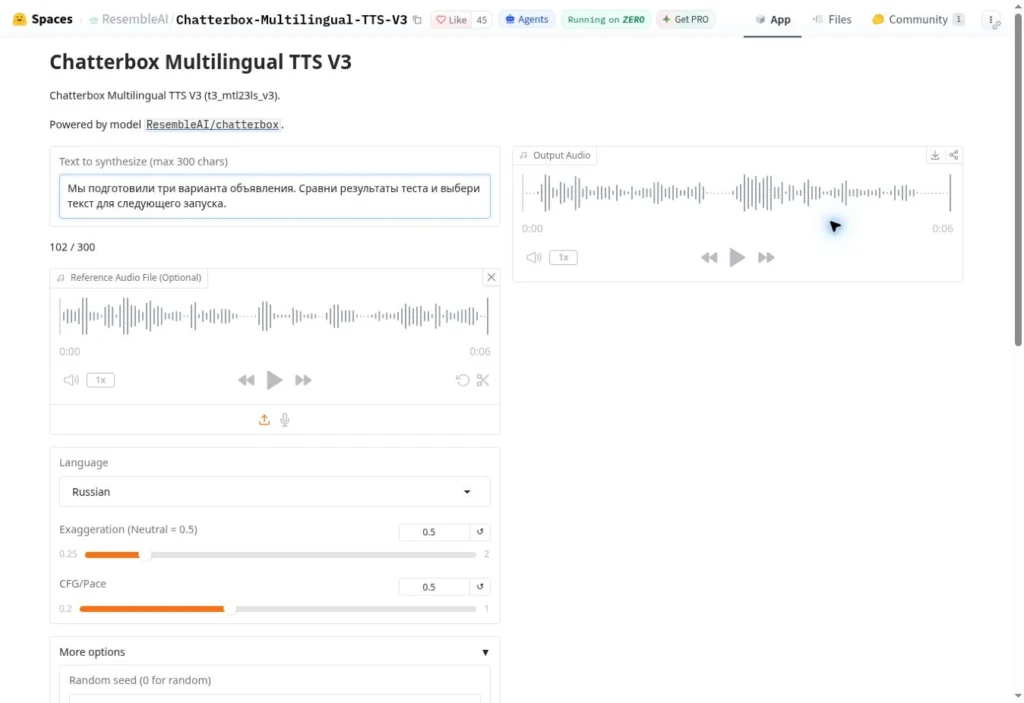
Для первого знакомства открой официальную демоверсию Multilingual V3 на Hugging Face. Она позволяет проверить настройки в браузере до локальной установки. На момент проверки в форме установлен предел 300 символов; это ограничение этой демоверсии, а не универсальный лимит Chatterbox.
Порядок работы такой:
- Выбери Russian в Language. После смены языка проверь текст и аудиообразец: демоверсия может подставить пример для выбранного языка.
- Вставь короткую реплику. Начни с одного-двух предложений. Числа и сокращения запиши так, как они должны прозвучать.
- Проверь Reference Audio File. Для знакомства оставь предоставленный разработчиком образец. Для своего проекта загружай запись голоса, на использование которого у тебя есть разрешение.
- Оставь Exaggeration и CFG/Pace на 0,5. Сначала получи исходный вариант, с которым будешь сравнивать изменения.
- Нажми Generate и дождись результата в Output Audio. Проверь, что обработка закончилась: после изменения текста в проигрывателе некоторое время может оставаться предыдущий результат.
- Прослушай дорожку и скачай её через Download. Сверь произнесённые слова с исходником до монтажа.
Для пробы подойдёт такой редакционный пример: «Мы подготовили три варианта объявления. Сравни результаты теста и выбери текст для следующего запуска». Здесь нет числовых обозначений и сокращений, поэтому проще начать с проверки обычной русской фразы.
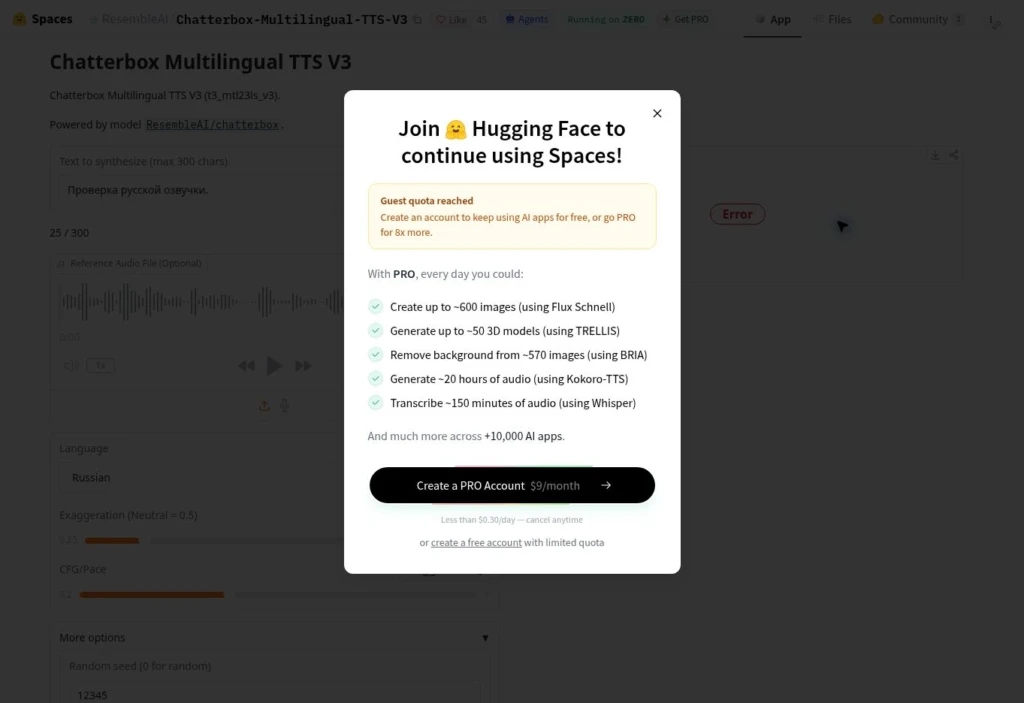
При проверке демоверсия показала Guest quota reached с предложением войти в Hugging Face. Постоянное число бесплатных генераций по одному тесту определить нельзя. Это ограничение хостинга демоверсии. Для регулярной работы рассматривай самостоятельный запуск либо отдельный облачный сервис.
Как подготовить голос и текст
Для воспроизведения голоса используй чистую запись одного человека без фоновой музыки, эха и чужих реплик. В примерах Turbo разработчик использует образец примерно на десять секунд, но это не обещание, что любая десятисекундная запись даст одинаковое сходство.
Для русской озвучки начни с русского образца. При переносе голоса с другого языка может сохраниться акцент исходной записи. Разработчик рекомендует в таком случае попробовать уменьшить cfg_weight, вплоть до нуля. Сравни результат с исходным вариантом: изменение затрагивает управление генерацией, а не служит гарантированным исправлением акцента.
Перед отправкой текста раскрой числа и сокращения. Например, «CTR вырос до 3,5%» можно подготовить для озвучки как «Си-ти-ар вырос до трёх с половиной процентов». Написание зависит от того, как ты хочешь произнести термин. Для брендов с неоднозначным чтением сначала проверь короткую фразу с одним названием.
В старых пользовательских обсуждениях Multilingual встречаются ошибки чтения чисел и перехода на другой язык. Эти сообщения относятся к версиям до V3 и не доказывают такую же частоту ошибок сегодня. Приём с записью чисел словами остаётся полезным: ты заранее задаёшь нужную формулировку вместо того, чтобы полагаться на интерпретацию цифр моделью.
Длинный сценарий удобнее разбить на смысловые фрагменты и сохранять отдельными файлами. Тогда ошибку в одной реплике можно исправить без повторной генерации всего ролика. При склейке проверь, совпадают ли громкость, темп и характер голоса между дублями.
За что отвечают настройки
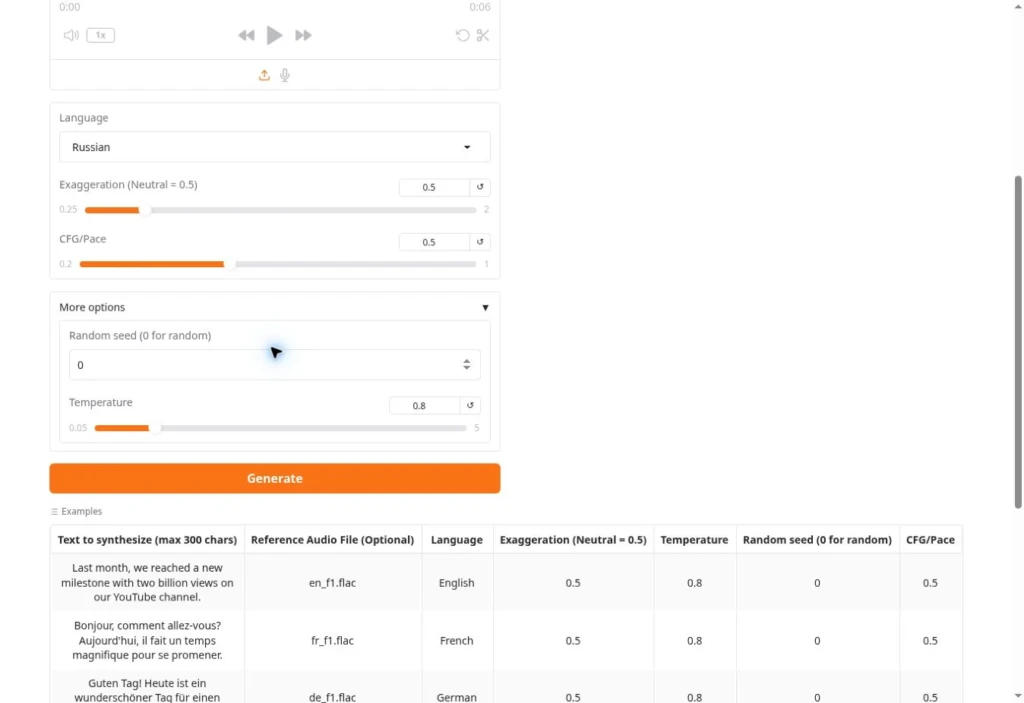
Exaggeration управляет выразительностью. Повышение значения может сделать подачу эмоциональнее и ускорить речь. Для исходной модели разработчик приводит пример сочетания примерно 0,7 для выразительности и 0,3 для cfg_weight, чтобы скорректировать темп. Это отправная точка для сравнения, а не универсальный пресет русской рекламы.
CFG/Pace в демоверсии связан с параметром cfg_weight. Он не задаёт точное количество слов в минуту. Если реплика должна занять заданные секунды, проверь длительность файла и сначала сократи текст; одним ползунком нельзя гарантированно попасть в хронометраж.
В More options находятся Temperature и Random seed. Для сравнения двух настроек оставь одинаковый текст, образец и фиксированный ненулевой seed. При значении 0 демоверсия выбирает случайный seed. Меняй один параметр за раз, чтобы понять, какая правка повлияла на результат.
Сохраняй вместе с удачным дублем название модели, версию, текст, образец и параметры. Это поможет повторить условия генерации после правки сценария. При обновлении модели даже те же настройки могут дать другое звучание.
Как запустить Multilingual V3 на компьютере
Самостоятельный запуск требует Python, зависимостей и загрузки весов модели. Разработчик тестировал проект с Python 3.11 на Debian 11. Код предусматривает CUDA, CPU и MPS, но скорость и совместимость зависят от оборудования и установленных версий библиотек. Универсальный минимум видеопамяти для всех вариантов запуска обещать нельзя.
Для V3 используй актуальный код официального репозитория. Пакет PyPI и ветка разработки обновляются независимо: на дату проверки последний опубликованный пакет chatterbox-tts — 0.1.7 от марта 2026 года, а V3 представлена в июне. Если установленная версия не принимает t3_model, проверь её происхождение и обнови код.
В отдельном окружении Python 3.11 установка из исходников выглядит так:
git clone https://github.com/resemble-ai/chatterbox.git
cd chatterbox
python -m venv .venv
source .venv/bin/activate
python -m pip install -e .
Команда активации выше предназначена для Linux/macOS. В Windows окружение активируется через .venv\Scripts\Activate.ps1 в PowerShell. Для NVIDIA проверь, что установленная версия PyTorch поддерживает CUDA.
Минимальный пример для текущего кода сохраняет русский результат в WAV:
import torchaudio as ta
from chatterbox.mtl_tts import ChatterboxMultilingualTTS

model = ChatterboxMultilingualTTS.from_pretrained(
    device="cuda",  # для запуска без CUDA выбери поддерживаемое устройство
    t3_model="v3",
)
wav = model.generate(
    "Мы подготовили три варианта объявления.",
    language_id="ru",
)
ta.save("voice-ru.wav", wav, model.sr)
Для своего голоса добавь в generate параметр audio_prompt_path=»reference.wav» с путём к разрешённому аудиообразцу.
Сколько стоит использование
Открытый проект распространяется под MIT: за каждый символ при самостоятельном запуске разработчик отдельную плату не берёт. При этом ты оплачиваешь своё оборудование, аренду вычислений, если она нужна, и время настройки. Цены облачной платформы Resemble AI и сторонних сайтов относятся к их услугам, а не к лицензии локальной модели.
Считать расходы удобнее по принятым дублям. Если из нескольких генераций в монтаж пошла одна, стоимость вычислений всех попыток относится к этой готовой реплике. К ней добавляется ручная проверка произношения и монтаж.
MIT допускает коммерческое использование кода с соблюдением условий лицензии, включая сохранение уведомления об авторских правах при распространении. Разрешение использовать чужой голос нужно получать отдельно: лицензия программы не предоставляет права на запись и личность диктора.
Chatterbox по умолчанию добавляет в аудио нейронный водяной знак PerTh. Он служит техническим признаком происхождения синтетической речи. Заявления о точности его обнаружения и устойчивости к обработке принадлежат разработчику; наличие знака не подтверждает согласие владельца голоса.
Когда выбирать Chatterbox
Chatterbox подходит для озвучки, где тебе нужен доступ к модели и собственным настройкам генерации. Для русского начни с Multilingual V3, короткой реплики и подходящего аудиообразца. Перед серией роликов проверь чтение брендов, чисел и темп на тех текстах, которые пойдут в работу.
Если важнее готовый редактор, библиотека голосов и работа без установки, сравни этот путь с ElevenLabs. Самостоятельный Chatterbox требует настройки и обслуживания; готовая платформа берёт эту работу на себя за плату.
FAQ
Да, русский поддерживает Multilingual, включая V3. Turbo и Nano предназначены для английского языка.
Открытую модель можно запускать без платы разработчику за каждый символ. Оборудование или аренда вычислений оплачиваются отдельно; у онлайн-демоверсии есть квота хостинга.
В актуальном коде передай t3_model=»v3″ при вызове ChatterboxMultilingualTTS.from_pretrained. Вызов без этого параметра по умолчанию выбирает V2.
Лицензия MIT допускает коммерческое использование кода с соблюдением её условий. Права на исходную запись и разрешение на воспроизведение голоса нужно получить отдельно.