Ollama — инструмент для запуска больших языковых моделей на собственном компьютере. С его помощью можно общаться с ИИ, писать и проверять код, анализировать документы, работать с изображениями и подключать нейросети к приложениям через API. Программа бесплатная, с открытым кодом. Модели работают на вашем компьютере, и запросы не уходят на сторонние серверы.
Для работы достаточно установить программу, скачать подходящую модель и запустить её одной командой. Ollama работает на Windows, macOS и Linux. Для ускорения подходят видеокарты NVIDIA и AMD, на Mac — чипы Apple Silicon. Параметры генерации, системный промт и настройки сервера можно менять.
Что такое Ollama и как она работает
Ollama скачивает модели, запускает их и даёт к ним доступ из терминала и из других программ через API. В библиотеке доступны семейства Gemma, Qwen, DeepSeek, Llama и другие.
Ollama работает как фоновый сервер на адресе http://localhost:11434. Команды из терминала и сторонние программы отправляют запросы ему, а он передаёт их модели. При первом обращении файлы модели скачиваются на диск. Если модель целиком помещается в видеопамять, она считается на GPU. Если нет, часть слоёв уходит на процессор.
Как установить Ollama на компьютер
Скачивайте установщик с официальной страницы ollama.com/download. Перед установкой проверьте свободное место на диске: файлы моделей весят от сотен мегабайт до сотен гигабайт.
Установка на Windows
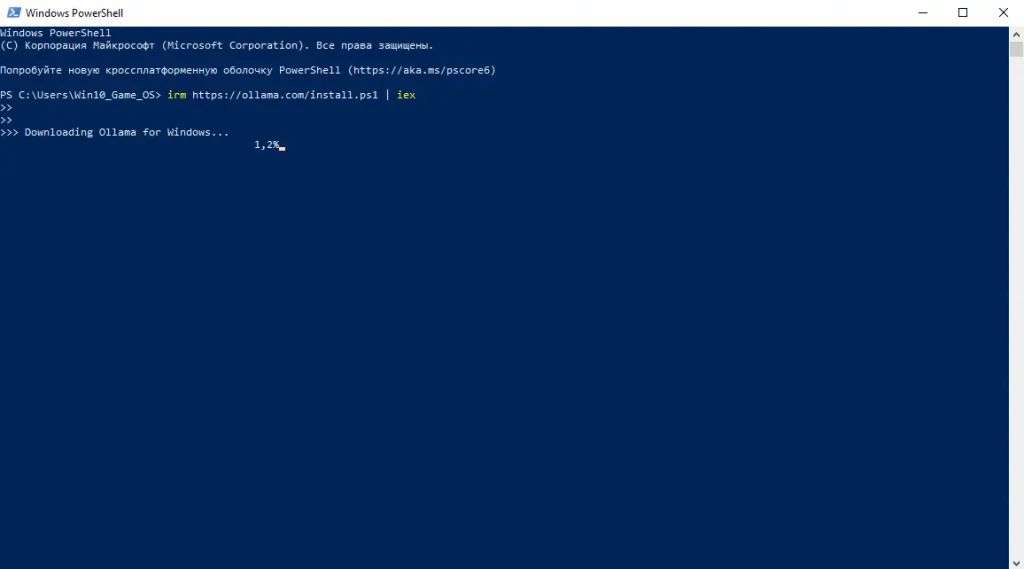
- Скачайте установщик для Windows с официального сайта и запустите его.
- Дождитесь завершения установки.
- Откройте PowerShell или Windows Terminal и проверьте работу программы:
ollama —version
Если команда не распознаётся, закройте и снова откройте терминал. Если не помогло, проверьте, есть ли папка программы в переменной PATH.
Установка на macOS
Скачайте приложение с официального сайта и перенесите его в папку Applications, следуя инструкции установщика. После запуска приложения откройте Terminal и выполните:
ollama —version
На Mac с чипами серии M модель использует общую память компьютера: на 16 ГБ комфортно работают модели примерно до 8B параметров.
Установка на Linux
Установка одной командой через официальный скрипт:
curl -fsSL https://ollama.com/install.sh | sh
Проверьте версию:
ollama —version
Если служба не запущена автоматически, её можно активировать через systemd:
sudo systemctl start ollama
sudo systemctl status ollama
Ручная установка и настройка драйверов NVIDIA и AMD описаны на docs.ollama.com/linux.
Первый запуск и использование Ollama
Для знакомства с инструментом подойдёт небольшая модель. Например, команда ниже скачает Gemma 4 и откроет диалог:
ollama run gemma4
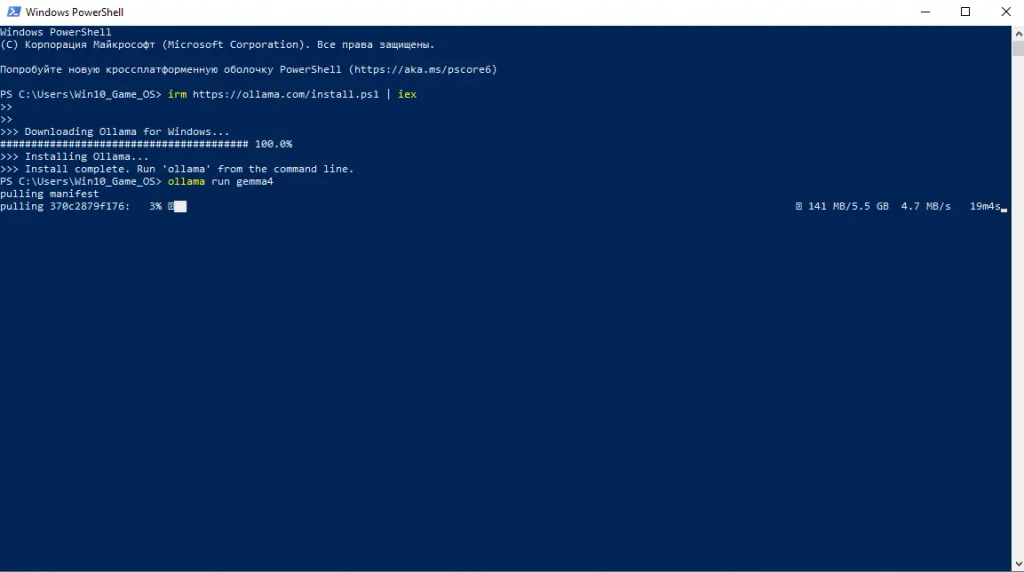
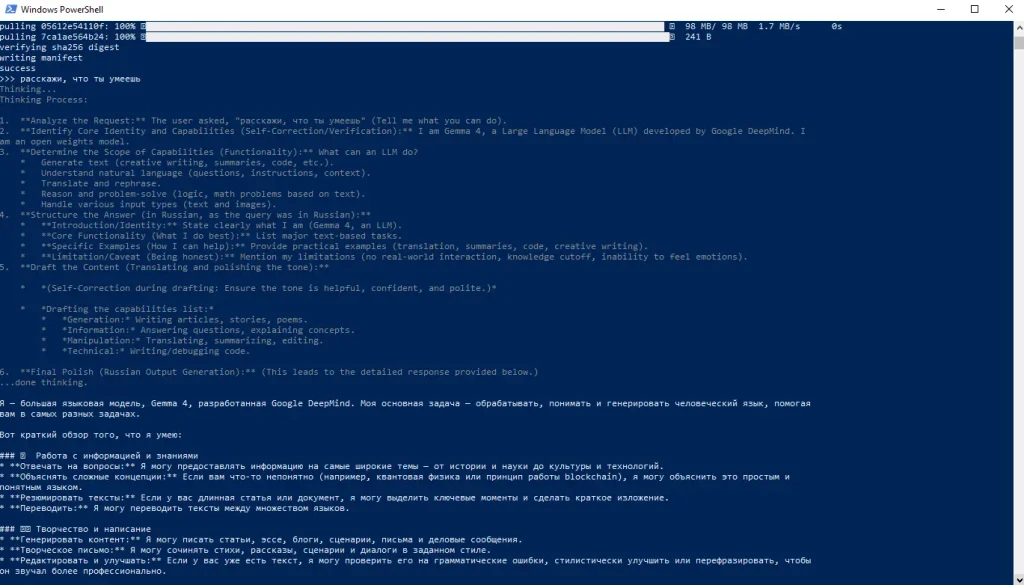
После загрузки введите запрос в терминале. Для выхода из диалога используйте /bye. При следующем запуске повторно скачивать уже установленную модель не потребуется.
Если нужно заранее загрузить модель, не открывая диалог, выполните:
ollama pull gemma4
Проверить, какие модели сохранены локально, можно командой:
ollama list
На карточке каждой модели в ollama.com/library указаны размеры вариантов и готовая команда для запуска.
Модели Ollama: какую выбрать
При выборе учитывайте размер файла, качество ответов, длину контекста и требования к памяти. Число параметров само по себе не определяет производительность: имеют значение архитектура, квантизация и характер задачи.
| Модель | Примерный размер | Ориентир по RAM | Для чего подходит |
| Gemma 4: легкий вариант | Зависит от тега | От 8 ГБ | Чат, краткие тексты, простые задачи |
| Qwen3: 8B | Около 5 ГБ | 8–16 ГБ | Русский язык, анализ, код |
| DeepSeek-R1: 8B | Около 5 ГБ | 8–16 ГБ | Логические задачи, объяснения |
| Qwen3: 14B | Около 9 ГБ | От 16 ГБ | Программирование, более сложные запросы |
| Gemma: 27B | Зависит от версии и квантизации | От 24–32 ГБ | Сложные тексты и анализ |
Модель занимает в памяти больше, чем весит файл: к весам добавляется кэш контекста, и чем длиннее контекст, тем он больше. Для GPU дополнительно учитывайте объём VRAM; если модель не помещается в видеопамять, часть вычислений может перейти на CPU и замедлить генерацию.
Квантизация уменьшает точность представления весов, благодаря чему сокращается объём памяти. Для повседневных задач часто достаточно вариантов Q4, но качество может отличаться от более точных сборок. Сверяйте конкретный размер в библиотеке перед загрузкой.
Основные команды Ollama
| Команда | Назначение |
| ollama run qwen3 | Скачать при необходимости и запустить модель |
| ollama pull qwen3 | Скачать модель |
| ollama list | Показать установленные модели |
| ollama show qwen3 | Показать сведения о модели |
| ollama ps | Показать запущенные модели |
| ollama stop qwen3 | Остановить модель |
| ollama rm qwen3 | Удалить локальную модель |
| ollama —version | Проверить версию программы |
| ollama serve | Запустить сервер вручную, если Ollama не работает как служба |
| ollama create mymodel -f Modelfile | Создать модель с пользовательской конфигурацией |
Заменяйте qwen3 на фактическое имя установленной модели. Если сервер уже работает как фоновая служба или приложение, повторный запуск ollama serve может завершиться ошибкой из-за занятого порта.
Ollama для программирования: API и интеграции
Сервер принимает обычные HTTP-запросы, поэтому подключить его можно из любого языка программирования. Например, API чата принимает запросы по адресу http://localhost:11434/api/chat.
Пример для Linux и macOS с установленным curl:
curl http://localhost:11434/api/chat \
-H «Content-Type: application/json» \
-d ‘{
«model»: «qwen2.5:7b»,
«messages»: [
{
«role»: «user»,
«content»: «Напиши функцию Python для проверки простого числа»
}
],
«stream»: false
}’
Имя модели должно совпадать с установленным тегом. Ответ приходит в JSON, а текст генерации находится в поле message.content. Остальные методы и параметры описаны в документации API.
Для Python доступна официальная библиотека:
pip install ollama
from ollama import chat
response = chat(
model=»qwen2.5:7b»,
messages=[
{«role»: «user», «content»: «Объясни работу декоратора Python»}
],
)
print(response.message.content)
Ollama подключается к редакторам кода через расширения Continue (VS Code, JetBrains) и Cline, а также к консольному агенту Aider. В настройках выбирают провайдера Ollama и указывают адрес http://localhost:11434. Код проекта при этом остаётся на вашем компьютере.
Частые ошибки при запуске
Команда ollama не найдена. Перезапустите терминал после установки, проверьте PATH и убедитесь, что установка завершилась без ошибок.
Ошибка подключения к серверу. Проверьте, запущено ли приложение или служба, и доступен ли адрес http://localhost:11434. На Linux поможет команда systemctl status ollama.
Не хватает памяти. Выберите модель меньшего размера или более сильной квантизации, сократите контекст через num_ctx и закройте приложения, расходующие RAM и VRAM.
Модель долго отвечает. Проверьте загрузку CPU и GPU, размер модели и число токенов контекста. При работе на процессоре крупная модель может генерировать текст значительно медленнее, чем на совместимой видеокарте.
Модель не скачивается. Проверьте подключение к сети, свободное место и точность имени тега в библиотеке. Если ошибка сохраняется, обновите Ollama и посмотрите лог: на Linux — journalctl -u ollama, на Windows — файл server.log в папке %LOCALAPPDATA%\Ollama.
FAQ
После установки программы и загрузки модели локальные запросы могут выполняться без подключения к сети. Интернет понадобится для скачивания новых моделей и обновлений, а облачные модели требуют сетевого доступа.
Для моделей примерно на 7–8 млрд параметров обычно стоит рассчитывать на 8–16 ГБ RAM, а для вариантов на 14 млрд — на 16–32 ГБ. Это ориентиры: длинный контекст и параллельные запросы увеличивают расход памяти.
Да, если хватает памяти и ресурсов компьютера. Фактическая производительность зависит от размеров моделей, доступной RAM и VRAM, контекста и настроек параллельной обработки.
Каталог зависит от операционной системы и настроек. В Windows стандартное расположение — C:\Users\%username%\.ollama\models, в macOS и Linux обычно используется ~/.ollama/models. Изменить каталог можно с помощью переменной OLLAMA_MODELS.